1 简介
Spring AI 的普通Advisor采用单次执行模型:请求沿着Advisor链流转,抵达大模型,再将响应原路返回。该模式适合简单交互场景;但当我们需要迭代行为时(例如结构化输出失败后重试、连续执行多次工具调用),普通Advisor就力不从心。
Spring AI 1.1版本引入了**递归Advisor(Recursive Advisors)**来解决该问题。
递归Advisor可以多次循环执行下游Advisor链,反复调用大模型,直到满足指定终止条件。
本教程将介绍递归Advisor的工作原理,分析两个内置实现,并手把手实现一个自定义递归Advisor。
2 Maven依赖
示例基于 Spring Boot 3.5 + Spring AI 1.1.2。
Spring AI 1.1 要求 Spring Boot 3.4 或 3.5。Spring AI 2.0 主要用于支持 Spring Boot 4。
在 pom.xml引入Spring AI BOM以及OpenAI启动器:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 |
<dependencyManagement> <dependencies> <dependency> <groupId>org.springframework.ai</groupId> <artifactId>spring-ai-bom</artifactId> <version>1.1.2</version> <type>pom</type> <scope>import</scope> </dependency> </dependencies> </dependencyManagement> <dependencies> <dependency> <groupId>org.springframework.ai</groupId> <artifactId>spring-ai-starter-model-openai</artifactId> </dependency> </dependencies> |
可以把OpenAI启动器替换为其他已支持模型,Advisor业务代码无需改动。
3 递归Advisor工作原理
普通Advisor只会处理一次请求:把请求交给下游链,等待响应,再原路返回,流程是线性的。
递归Advisor打破了单次执行模型: 它拿到响应后做判断,如果结果不满足条件,则重新循环执行下游链路,再次发起尝试。每一轮迭代,都会完整执行递归Advisor下游的全部Advisor,并且再次调用大模型。
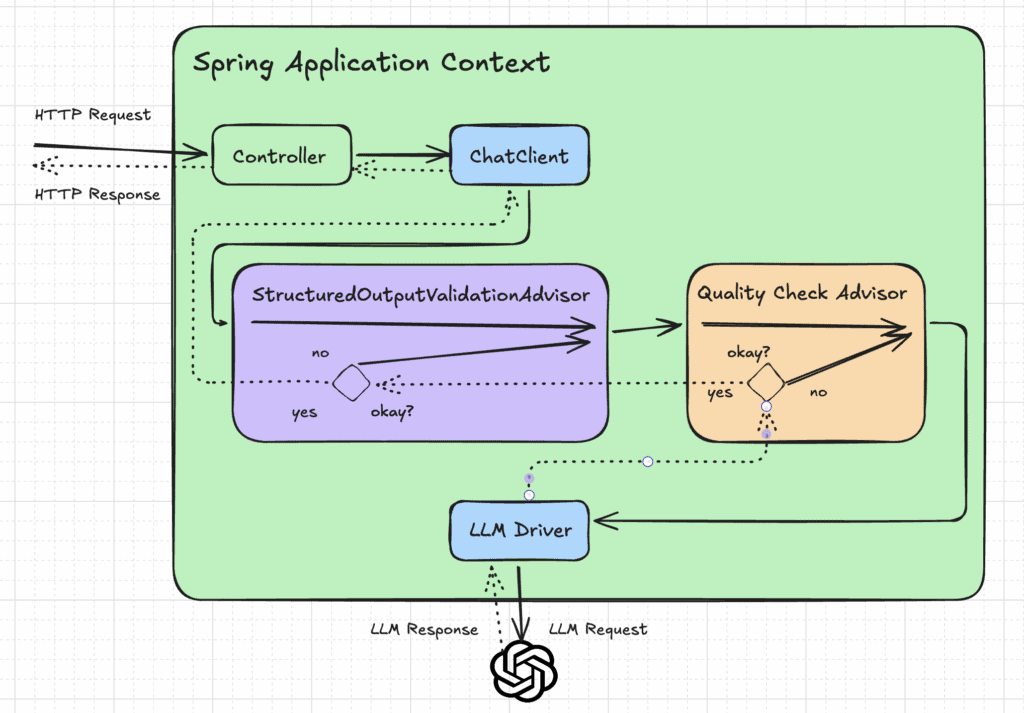
该模式有两个重要特性:
- 只有递归Advisor下游的Advisor会在每一轮循环重复执行;位于递归Advisor上游的Advisor只会在最开始执行一次。
- 下游Advisor可以观测每一次迭代。例如放在递归Advisor之后的日志Advisor,能够捕获每一次重试请求,保证完整可观测性。
⚠️每一个递归Advisor都必须定义终止条件。如果没有最大重试次数或者明确退出条件,会出现无限循环,持续消耗Token,产生额外费用。
补充:当然,也可以直接在业务代码写while循环包装ChatClient调用。而递归Advisor把迭代逻辑收归到Advisor链路内部,保留完整可观测性,允许其他Advisor拦截每一次迭代。
4 内置递归Advisor
Spring AI内置两个递归Advisor,覆盖最常见业务场景。
4.1 ToolCallAdvisor(工具调用Advisor)
默认情况下,Spring AI的工具调用逻辑写在ChatModel实现内部。而ToolCallAdvisor把工具调用循环迁移到Advisor链路中,让链路上其他Advisor能够完整观测每一轮工具调用的完整交互。
示例:汇率转换工具,入参为CurrencyRequest记录,返回汇率。
|
1 2 3 4 5 6 7 8 9 |
public record CurrencyRequest(String fromCurrency, String toCurrency) {} var exchangeRateTool = FunctionToolCallback .builder( "getExchangeRate", (CurrencyRequest req) -> "1 " + req.fromCurrency() + " = 0.91 " + req.toCurrency()) .description("Gets the current exchange rate between two currencies") .inputType(CurrencyRequest.class) .build(); |
将工具与Advisor装配进ChatClient:
|
1 2 3 4 5 6 7 8 9 10 11 |
var toolCallAdvisor = ToolCallAdvisor .builder() .toolCallingManager(toolCallingManager) .advisorOrder(BaseAdvisor.HIGHEST_PRECEDENCE + 300) .build(); var chatClient = ChatClient .builder(chatModel) .defaultAdvisors(toolCallAdvisor) .defaultToolCallbacks(exchangeRateTool) .build(); |
当大模型返回结果携带工具调用指令时,Advisor执行工具,将工具执行结果送回提示词,继续循环。直到大模型返回最终文本响应,不再触发工具调用,循环结束。
如下提问会触发两轮工具调用,分别处理两组货币转换:
|
1 2 3 4 5 |
String answer = chatClient .prompt() .user("Convert 500 USD to EUR and then to GBP") .call() .content(); |
Advisor对上层透明地处理全部迭代。
该Advisor还支持直接返回模式:当工具设置returnDirect=true,Advisor会跳过后续大模型调用,直接将工具输出返回给客户端。
4.2 StructuredOutputValidationAdvisor(结构化输出校验Advisor)
该Advisor用于校验大模型返回JSON是否符合Java Record推导出来的Schema。校验失败时,把错误详情追加进提示词,自动重试。
示例:定义BookSummary记录,包含书名、作者、主题列表。
|
1 |
public record BookSummary(String title, String author, List<String> themes) {} |
配置Advisor,设置最大重试5次:
|
1 2 3 4 5 |
var validationAdvisor = StructuredOutputValidationAdvisor .builder() .outputType(BookSummary.class) .maxRepeatAttempts(5) .build(); |
构建ChatClient:
|
1 2 3 4 |
var chatClient = ChatClient .builder(chatModel) .defaultAdvisors(validationAdvisor) .build(); |
调用ChatClient时指定目标返回类型:
|
1 2 3 4 5 |
BookSummary result = chatClient .prompt() .user("Summarize '1984' by George Orwell with its main themes") .call() .entity(BookSummary.class); |
⚠️必须配置
maxRepeatAttempts,用来防止无限重试循环;默认值为3。
5 实现自定义递归Advisor
接下来实现QualityCheckAdvisor:校验大模型回答的文本长度,如果回答内容达不到阈值,追加反馈提示词并自动重试。自定义Advisor实现CallAdvisor接口。
|
1 2 3 4 5 6 |
public class QualityCheckAdvisor implements CallAdvisor { private static final int MAX_RETRIES = 3; // ... } |
硬性设置最大重试上限。所有递归Advisor必须提供终止条件,防止死循环。
核心逻辑写在adviseCall方法:先正常把请求交给链路向下传递。
|
1 2 3 4 5 6 7 8 9 10 11 |
@Override public ChatClientResponse adviseCall(ChatClientRequest request, CallAdvisorChain chain) { ChatClientResponse response = chain.nextCall(request); int attempts = 0; while (attempts < MAX_RETRIES && !isHighQuality(response)) { // ... attempts++; } return response; } |
只要响应不满足质量标准,就扩充提示词,带上反馈信息,重新执行下游子链。
关键API:
chain.copy(this).nextCall(),会生成一条全新子链,起点为当前Advisor的下游。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 |
String feedback = "Your previous answer was incomplete. " + "Please provide a more thorough response."; var augmentedPrompt = request .prompt() .augmentUserMessage( userMessage -> userMessage.mutate().text(userMessage.getText() + System.lineSeparator() + feedback) .build()); var augmentedRequest = request .mutate() .prompt(augmentedPrompt) .build(); response = chain .copy(this) .nextCall(augmentedRequest); |
质量校验逻辑,判断响应文本大于200字符:
|
1 2 3 4 5 6 7 8 9 |
private boolean isHighQuality(ChatClientResponse response) { String content = response .chatResponse() .getResult() .getOutput() .getText(); return content != null && content.length() > 200; } |
注册Advisor到ChatClient:
|
1 2 3 4 |
var chatClient = ChatClient .builder(chatModel) .defaultAdvisors(new QualityCheckAdvisor()) .build(); |
注意:递归Advisor目前只支持非流式模式,必须拿到完整响应之后,才能判断是否需要重试。
6 单元测试
在单元测试中直接调用真实大模型,结果不可预测,执行速度慢。所以对ChatModel做Mock模拟,精准控制返回内容,单独验证重试逻辑。
测试思路:Mock对象第一次返回很短的文本(不通过质量校验);第二次返回满足长度要求的长文本。Advisor应当恰好触发一次重试。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 |
@SpringBootTest class QualityCheckAdvisorTests { @MockitoBean ChatModel chatModel; @Autowired ChatClient.Builder chatClientBuilder; @Test void givenShortFirstResponse_whenAdvised_thenRetriesAndReturnsLongResponse() { var shortResponse = "Too brief."; var longResponse = "S".repeat(250); when(chatModel.call(any(Prompt.class))) .thenReturn(createChatResponse(shortResponse)) .thenReturn(createChatResponse(longResponse)); var chatClient = chatClientBuilder .defaultAdvisors(new QualityCheckAdvisor()) .build(); String result = chatClient.prompt() .user("Explain the SOLID principles.") .call() .content(); assertThat(result).hasSize(250); verify(chatModel, times(2)).call(any(Prompt.class)); } private ChatResponse createChatResponse(String content) { return new ChatResponse( List.of(new Generation(new AssistantMessage(content))) ); } } |
verify()是本测试核心断言,证明Advisor确实触发了一次重试。第一次返回的内容字符数不足,进入循环;第二次返回满足条件,循环退出。
7 性能与执行顺序考量
递归Advisor会增加大模型调用次数;每一轮迭代都会带来成本、延迟、Token消耗的上涨。
| 关注点 | 影响 | 缓解方案 |
|---|---|---|
| API费用 | 每一轮循环都会新增一次LLM调用 | 设置严格的重试上限 |
| 延迟 | 多次网络往返叠加耗时 | 尽可能缓存中间结果 |
| Token消耗 | 每轮迭代完整重传全部提示词 | 精简扩充后的提示词 |
| Advisor顺序 | 决定哪些Advisor可以观测每一轮迭代 | 根据可观测性需求,把递归Advisor放在链路靠前或者靠后的位置 |
需要有意识地规划递归Advisor在链中的位置。
ToolCallAdvisor一般设置接近最高优先级HIGHEST_PRECEDENCE,让内部Advisor能够观测工具执行;StructuredOutputValidationAdvisor一般接近最低优先级LOWEST_PRECEDENCE,在调用模型之前最后执行。
8 总结
本教程介绍Spring AI递归Advisor,它打破普通Advisor单次执行模型,实现迭代重试模式。可以用于工具调用循环、结构化输出校验、自定义质量校验场景,全部复用统一的Advisor抽象体系。