什么是递归Advisor
递归Advisor是一类特殊Advisor,可以多次循环执行下游Advisor链。当需要反复调用大模型,直到满足特定终止条件时,就适合使用该模式,典型场景:
- 循环执行工具调用,直到不再需要调用任何工具
- 校验结构化输出,校验失败自动重试
- 修改请求报文,实现结果评估逻辑
- 修改请求报文,实现重试逻辑
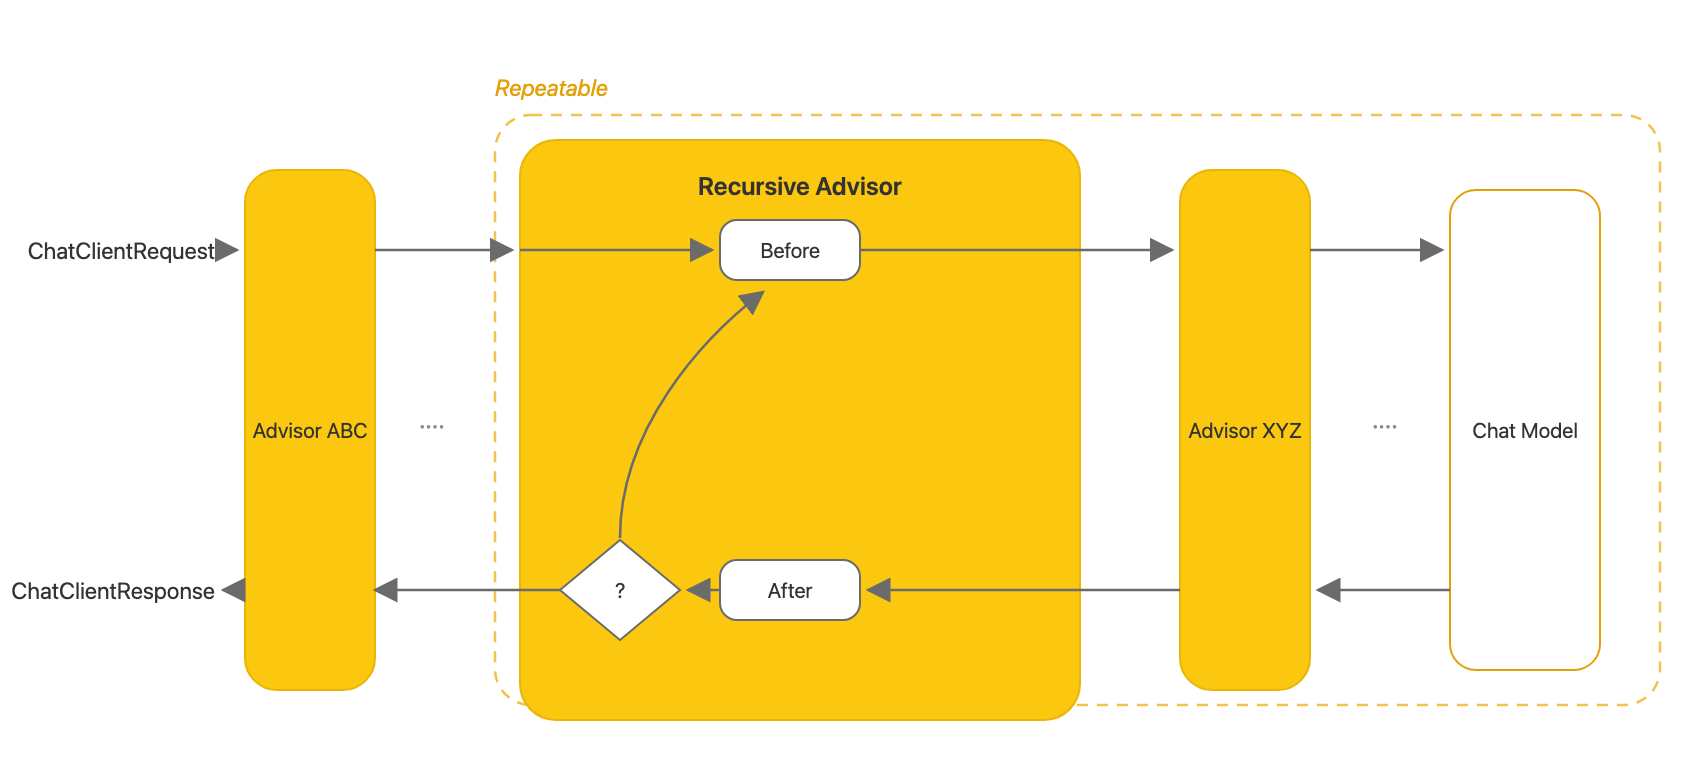
CallAdvisorChain.copy(CallAdvisor after) 是实现递归Advisor模式的核心工具方法。 该方法会创建一条全新子Advisor链,仅包含原始链中指定Advisor之后的所有Advisor,递归Advisor可以按需调用这条子链。该机制带来如下保障:
- 递归Advisor可以循环执行链中剩余下游Advisor;
- 链上其他Advisor可以观测、拦截每一轮迭代;
- Advisor链维持正确执行顺序与完整可观测性;
- 排在递归Advisor上游的Advisor不会被重复执行。
内置递归Advisor
Spring AI内置两个递归Advisor,演示这套模式的标准用法。
ToolCallingAdvisor(工具调用Advisor)
ToolCallingAdvisor 将工具调用循环逻辑放到Advisor链路内部实现,而不是依赖各个ChatModel内部逻辑。 只要配置了工具,DefaultChatClient会自动注册该Advisor;它也是ChatClient实现工具增强对话的默认实现。
主要特性:
- 循环执行Advisor链,直到
ToolExecutionEligibilityChecker判定不再需要执行工具调用; - 使用
callAdvisorChain.copy(this)生成递归调用子链;链上其他Advisor可以观测、拦截每一轮迭代; - 支持
returnDirect直接返回模式:当工具返回结果标记returnDirect=true,Advisor直接把工具结果返回调用方,不再回传给大模型; - 实现标记接口
ToolAdvisor;DefaultChatClient保证整条链只会存在一个ToolAdvisor;自定义子类可以直接替换原有实现; - 累加每一轮循环的Token消耗,最终返回的
ChatResponse会报告全部模型调用的累计用量,而不只是最后一次调用用量(参考文档:多步流程下的累计用量)。
代码示例:
|
1 2 3 4 5 6 7 8 |
var toolCallingAdvisor = ToolCallingAdvisor.builder() .toolCallingManager(toolCallingManager) .advisorOrder(BaseAdvisor.HIGHEST_PRECEDENCE + 300) .build(); var chatClient = ChatClient.builder(chatModel) .defaultAdvisors(toolCallingAdvisor) .build(); |
更多完整构建器API、钩子方法、配置项、内存Advisor顺序冲突、自定义子类扩展,参见
ToolCallingAdvisor文档。 想要了解工具调用循环在整体工具架构中的定位,阅读《工具调用:工具调用循环》。 查看基于该Advisor扩展钩子实现渐进式工具披露的示例:Tool Search Tool。
StructuredOutputValidationAdvisor(结构化输出校验Advisor)
StructuredOutputValidationAdvisor校验大模型返回JSON是否匹配JSON Schema;校验失败则重新发起调用,重试次数可配置。
主要特性:
- 可以从目标输出类型自动推导JSON Schema,也支持传入预先定义好的Schema字符串;
- 使用JSON Schema校验大模型响应;
- 校验失败自动重试,默认最多重试3次;
- 重试时将校验错误信息追加进提示词,引导大模型自我修正输出;
- 使用
callAdvisorChain.copy(this)生成递归调用子链; - 累加每一次重试的Token消耗;返回的
ChatResponse包含全部重试调用的累计用量; - 可配置自定义
JsonMapper。
二选一配置:
outputType(自动推导Schema)或者outputJsonSchema(传入现成Schema字符串),两者互斥。
示例一:通过Java类型自动推导Schema
|
1 2 3 4 5 6 7 8 |
var validationAdvisor = StructuredOutputValidationAdvisor.builder() .outputType(MyResponseType.class) .maxRepeatAttempts(3) .build(); var chatClient = ChatClient.builder(chatModel) .defaultAdvisors(validationAdvisor) .build(); |
示例二:传入预先准备好的JSON Schema
|
1 2 3 |
var validationAdvisor = StructuredOutputValidationAdvisor.builder() .outputJsonSchema(myConverter.getJsonSchema()) .build(); |
不需要手动注册Advisor,可以直接在.entity()调用通过EntityParamSpec开启校验:
|
1 2 3 4 |
ActorFilms actorFilms = chatClient.prompt() .user("Generate the filmography for a random actor.") .call() .entity(ActorFilms.class, spec -> spec.validateSchema()); |
高层用法详见《模式校验与自修复》章节。
在自定义递归Advisor中累积Token用量
单次递归Advisor执行会触发多次大模型调用,因此必须累加每一次调用的Token消耗,否则调用方只能拿到最后一次调用的用量统计。
Spring AI提供工具类org.springframework.ai.chat.client.advisor.UsageAccumulator简化该逻辑:
- 每一次
adviseCall方法内部新建一个UsageAccumulator实例;流式场景在Flux.defer内部创建,保证每个订阅独立; - 每一轮调用完成调用
addRoundResponse(…)存入该轮响应用量; - 循环结束调用
applyAccumulatedUsage(…),将累计用量写入最终返回响应对象。
代码模板:
|
1 2 3 4 5 6 7 8 9 |
UsageAccumulator usage = new UsageAccumulator(); ChatClientResponse response; do { response = callAdvisorChain.copy(this).nextCall(request); usage.addRoundResponse(response.chatResponse()); // ... 判断是否继续循环 ... } while (loopAgain); return usage.applyAccumulatedUsage(response); |
Token底层计算逻辑位于
org.springframework.ai.support.UsageCalculator,提供accumulateResponseUsage与withUsage方法;UsageAccumulator对它做了封装。